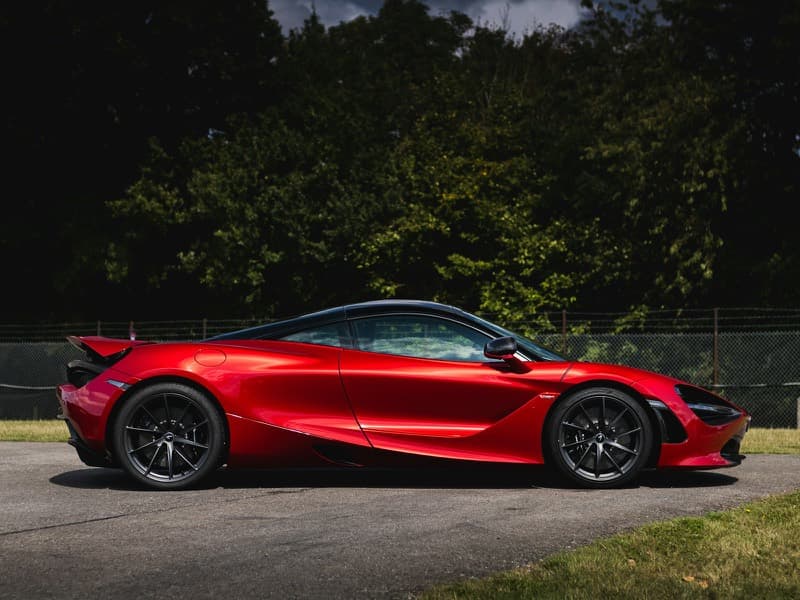
Vrais exemples de vidéos IA : de la miniature à la vraie voiture
Chaque vidéo de cette page a été générée par TrainWindowAI à partir de la photo affichée à côté, avec la même scène fixe que celle des clients. Rien n’a été coupé, étalonné ni redoublé. Les problèmes sont signalés, pas cachés.
À quoi ressemble une vraie génération TrainWindowAI ?
Modèle : ByteDance Seedance 2.0 Mini via APIMart. Format : 15 s · 720 × 1280 · 9:16 · MP4 avec son généré. Sur ces 8 vidéos, 3 ont gardé la voiture et la caméra cohérentes, 2 présentent des défauts mineurs et 3 des problèmes visibles. Le temps de rendu du modèle allait de 3 min 0 s à 3 min 47 s ; les contrôles de sécurité avant et après le rendu ajoutent du temps, et aucun délai de livraison n’est garanti.
Lors du lot de test du 29 octobre 2026, nous avons envoyé 8 photos : 7 ont été générées et 1 a été refusée par le fournisseur à l’envoi avec une erreur de lien d’image invalide ; il n’existe donc pas de vidéo pour elle. Chaque photo a été envoyée une seule fois, sans nouvelle tentative. C’est un petit échantillon ; il n’établit pas un taux de réussite à long terme.
La peinture, l’aileron arrière, les feux arrière et les roues restent reconnaissables de la miniature à la taille réelle. Le même angle de trois quarts arrière du début à la fin et une seule sortie de tunnel.
La photo de profil devient une vue de trois quarts arrière cohérente. La forme de la carrosserie et l’aileron arrière correspondent ; le modèle a dû inventer l’arrière, que la photo ne montre pas.
SUV intermédiaire noir
Cohérent
ENTRÉE · Photo de Duc Van sur Unsplash · Plaque et autocollant de la lunette arrière floutés avant l’envoi.
Carrosserie
SUV
Temps de rendu
3 min 0 s (modèle seul)
Version de la scène
Scène fixe actuelle
Ce que nous avons observé
La peinture sombre, les barres de toit, la rampe lumineuse et les roues restent cohérentes. La photo d’entrée coupe l’avant de la voiture ; l’angle de caméra uniquement arrière le masque.
La capote souple, les prises d’air latérales et les roues restent cohérentes. La voiture sort du tunnel plus tôt que prévu, et le modèle ajoute une plaque arrière aux caractères illisibles.
La couleur, la calandre chromée et les lignes de la carrosserie correspondent bien. La voiture fait face à la caméra pendant tout le clip au lieu de la vue arrière prévue, suivant la photo d’entrée prise de face.
La peinture et la calandre restent cohérentes, mais le pick-up fait face à la caméra presque tout le clip, puis apparaît soudain de dos dans le dernier plan extérieur, un saut d’orientation évident.
La couleur et les bandes sont conservées, mais la miniature est montrée de dos puis se tourne vers la caméra pendant la transition : le sens de marche s’inverse.
L’exemple de la page d’accueil. L’identité de la voiture et la sortie de tunnel unique tiennent, mais une main humaine apparaît au bord de la fenêtre dans les premières secondes, et le cadre de la fenêtre quitte vite le plan. Il utilisait un prompt de scène antérieur ; l’actuel interdit explicitement les mains.
L’IA conserve-t-elle bien la couleur, la forme et les roues de la voiture ?
La couleur de la peinture s’est maintenue dans toutes les vidéos ci-dessus. La forme de la carrosserie et les roues sont restées reconnaissables dans la plupart, mais le modèle invente ce que la photo ne montre pas : une photo de profil reçoit un arrière imaginé, et une photo de face peut entraîner la caméra vers l’avant, ce qui a causé les sauts d’orientation du pick-up et de la muscle car.
Quelle photo donne le meilleur résultat ?
Les résultats les plus cohérents viennent de photos prises de profil ou de trois quarts arrière, montrant toute la voiture sous une lumière uniforme. Consultez le tutoriel photo avant l’envoi.
Puis-je faire la même vidéo à la fenêtre du train avec ma voiture ?